Zero-Shot Vision trong Y tế: Khi AI “Nhìn” Mà Không Cần Học Trước
September 14, 2026
SAVINA ONE | Giải Pháp Chuyển Đổi Số Y Tế Cho Bệnh Viện Và Phòng Khám

 By
Lưu Phan Thanh
Cách đây không lâu, nếu muốn AI nhận diện một loại tổn thương mới trên ảnh y tế, chúng ta phải thu thập hàng ngàn ảnh, gán nhãn cẩn thận và huấn luyện lại một mô hình riêng. Mỗi lần có “loại hình ảnh mới”, lại phải lặp lại toàn bộ quy trình tốn kém và mất thời gian.
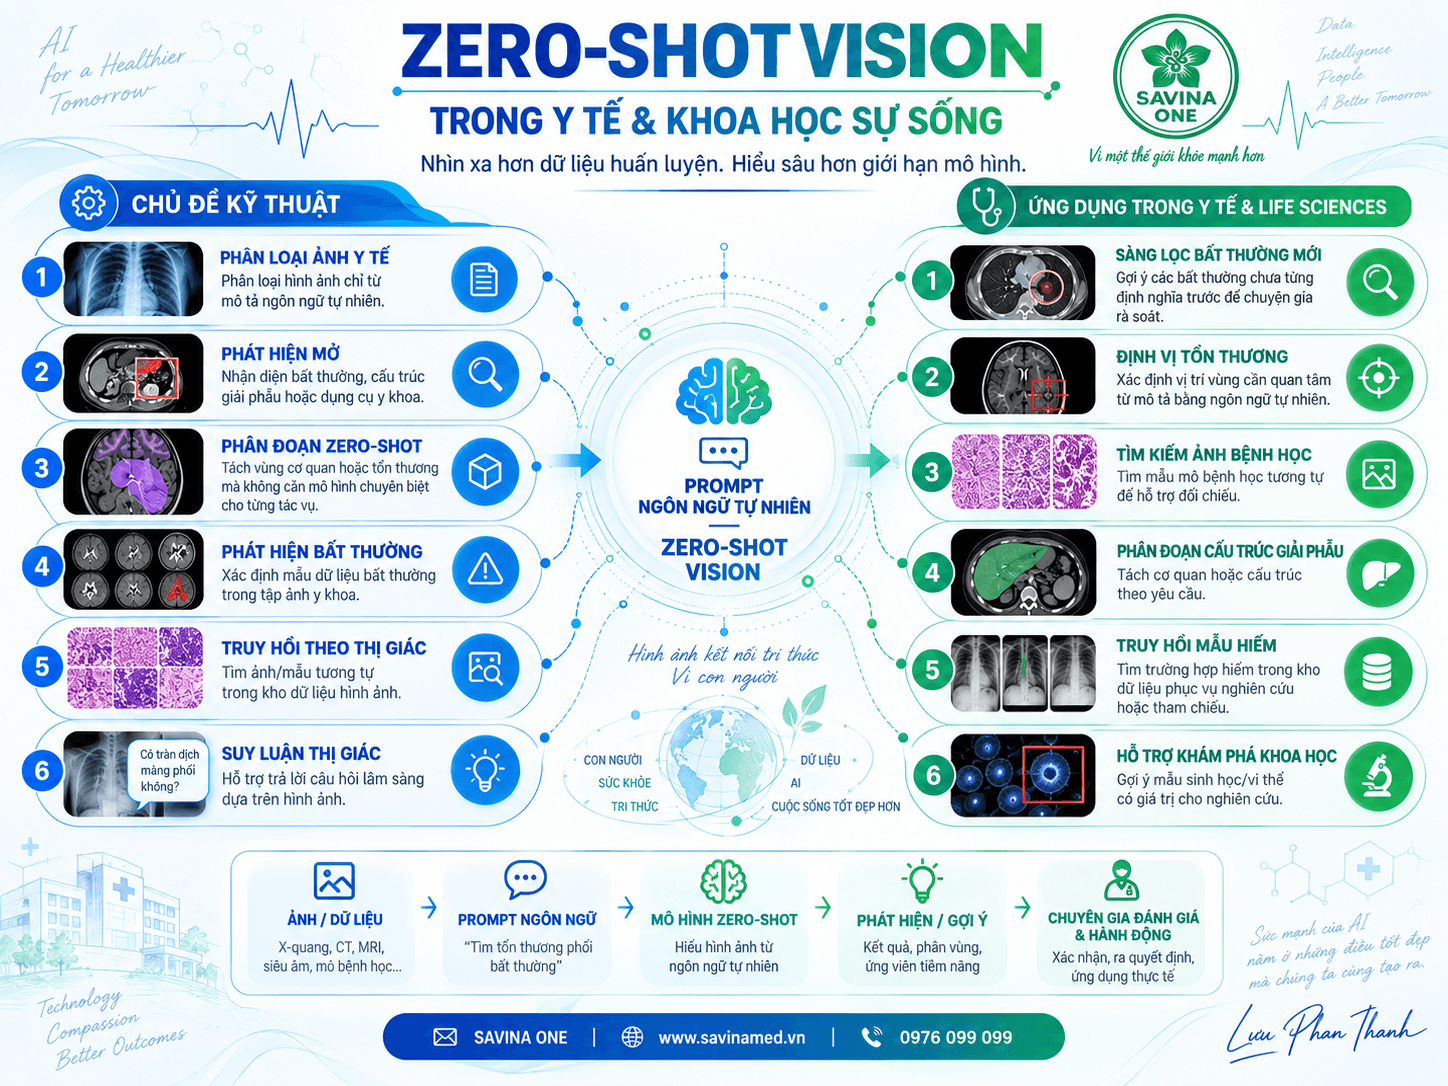
Zero-Shot Vision (tạm dịch: “thị giác không cần mẫu huấn luyện trước”) đang thay đổi hoàn toàn cách làm đó. Thay vì dạy AI từng lớp đối tượng cụ thể, chúng ta kết hợp mô hình nền tảng về hình ảnh với ngôn ngữ tự nhiên, rồi mô tả bằng lời thứ mình muốn AI tìm kiếm.
Nói đơn giản:
Trước đây: “Muốn AI tìm tổn thương A, phải cho nó xem rất nhiều ảnh có tổn thương A.”
Giờ đây: “Chỉ cần mô tả ‘tổn thương dạng tròn, viền không đều, nằm ở thùy trên phổi phải’ – AI sẽ cố gắng tìm những vùng phù hợp, ngay cả khi nó chưa từng được ‘học riêng’ về tổn thương đó.”
Vậy Zero-Shot Vision trong y tế thực sự làm được gì, và đâu là giới hạn cần lưu ý khi triển khai lâm sàng?
Zero-Shot Vision là một nhánh của Zero-Shot Learning (học không cần mẫu), trong đó AI có thể nhận diện, phân loại hoặc phân vùng các đối tượng mà nó chưa từng thấy trong quá trình huấn luyện.
Khác với AI truyền thống – vốn bị giới hạn ở những “lớp” (classes) đã được định nghĩa sẵn như “u gan”, “nốt phổi”, “hạch cổ” – Zero-Shot Vision cho phép AI làm việc với “từ điển mở”. Bạn có thể mô tả bất kỳ cấu trúc giải phẫu hay tổn thương nào bằng ngôn ngữ tự nhiên, và AI sẽ cố gắng “hiểu” để tìm kiếm.
Công nghệ này dựa trên Vision-Language Models (VLM) – các mô hình nền tảng kết hợp khả năng “nhìn” (xử lý ảnh) với “đọc hiểu” (xử lý ngôn ngữ).
Quy trình cơ bản gồm ba bước:
Mã hóa hình ảnh: Ảnh y tế (CT, MRI, X-quang, tiêu bản mô bệnh học…) được đưa qua một bộ mã hóa hình ảnh (image encoder) để trích xuất đặc trưng thị giác.
Mã hóa mô tả chữ: Câu lệnh của bác sĩ (ví dụ: “tìm tất cả hạch bất thường ở vùng cổ”) được đưa qua bộ mã hóa ngôn ngữ (text encoder) để trích xuất ý nghĩa ngữ nghĩa.
Khớp đặc trưng: Mô hình so sánh đặc trưng hình ảnh với đặc trưng ngôn ngữ, từ đó xác định vùng nào trên ảnh “phù hợp nhất” với mô tả.
Điểm then chốt: quá trình này không cần huấn luyện lại cho từng loại tổn thương mới. Chỉ cần thay đổi câu lệnh, AI sẽ tìm đối tượng khác.
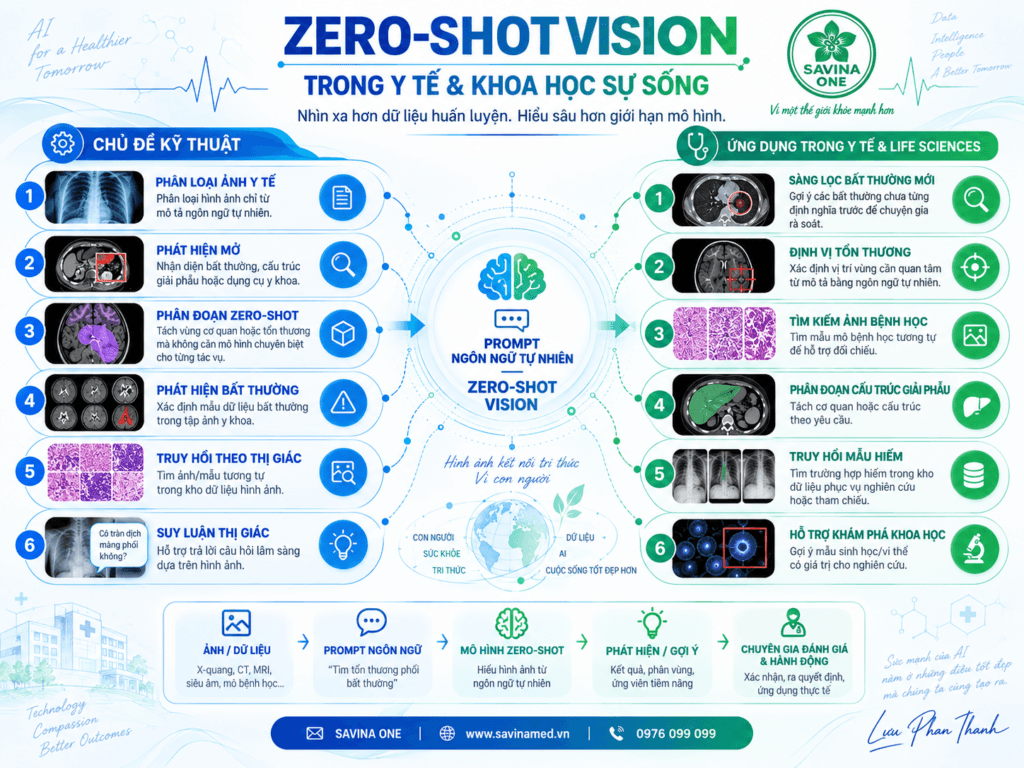
Bạn có thể gán nhãn cho ảnh CT, MRI, X-quang, tiêu bản mô bệnh học… dựa trên mô tả ngữ nghĩa, thay vì phải có sẵn bộ ảnh đã gắn nhãn cho từng loại bệnh.
Ví dụ: thay vì huấn luyện một mô hình riêng để phân biệt “viêm phổi do virus” và “viêm phổi do vi khuẩn”, bạn chỉ cần mô tả đặc điểm hình ảnh của từng loại, và AI sẽ phân loại dựa trên mô tả đó.
Dùng câu lệnh bằng ngôn ngữ tự nhiên để yêu cầu AI:
“Tìm tất cả hạch bất thường ở vùng cổ,”
“Chỉ ra các tổn thương dạng nốt ở phổi,”
“Khoanh vùng cấu trúc giải phẫu X trên MRI.”
Không cần định nghĩa trước “hạch” là gì, “nốt” ra sao – AI sẽ hiểu qua ngữ cảnh và đặc trưng hình ảnh đã học từ dữ liệu nền tảng.
Thay vì xây một mô hình segmentation riêng cho gan, rồi một mô hình khác cho thận, phổi… ta có thể mô tả cấu trúc cần phân vùng và để AI thực hiện trên nhiều loại ảnh khác nhau.
Nghiên cứu gần đây cho thấy VLM có thể đạt hiệu suất segmentation cạnh tranh với các mô hình chuyên biệt, nhưng chỉ với một mô hình duy nhất cho nhiều cấu trúc và nhiều modality (CT, MRI, PET).
AI có thể phát hiện những mẫu hình ảnh bất thường, ngay cả khi chúng ta chưa có đủ dữ liệu của tất cả các dạng bệnh hiếm gặp.
Điều này đặc biệt hữu ích với:
Bệnh hiếm, khó thu thập đủ mẫu để huấn luyện,
Bệnh mới nổi (ví dụ: vùng nhiễm trùng trong đại dịch mới),
Tổn thương không điển hình, ít gặp trong thực hành lâm sàng thường ngày.
Thay vì tìm theo mã bệnh, tên bác sĩ, ngày chụp… ta có thể:
“Tìm tất cả bệnh nhân có tổn thương dạng sao ở gan trên CT,”
“Tìm các tiêu bản mô bệnh học có vùng hoại tử lớn ở trung tâm khối u.”
Tính năng này hỗ trợ tra cứu ca bệnh tương tự, phục vụ hội chẩn, nghiên cứu và đào tạo.
AI có thể kết nối:
Phát hiện trên ảnh,
Ngữ cảnh giải phẫu,
Câu hỏi lâm sàng,
để đưa ra lập luận đa phương thức (hình ảnh + chữ).
Ví dụ: AI không chỉ khoanh vùng khối u, mà còn trả lời câu hỏi “khối u này có xâm lấn mạch máu không?” dựa trên cả hình ảnh và ngữ cảnh lâm sàng.
Dưới đây là một số tình huống Zero-Shot Vision có thể triển khai trong môi trường bệnh viện:
Sàng lọc tổn thương bất thường trên X-quang, CT, MRI – đặc biệt hữu ích ở khoa Chẩn đoán hình ảnh quá tải.
Định vị khối u, nốt phổi, tổn thương gan, thận phục vụ lập kế hoạch phẫu thuật hoặc xạ trị.
Tìm kiếm và so sánh các ca bệnh tương tự trong kho ảnh và tiêu bản mô bệnh học – hỗ trợ hội chẩn và nghiên cứu.
Phân vùng tự động các cấu trúc giải phẫu (gan, thận, phổi, tủy sống…) để tính thể tích, lập kế hoạch điều trị.
Tìm các mẫu bệnh hiếm, khó trên ảnh hiển vi, ảnh tế bào, ảnh mô bệnh học – nơi dữ liệu huấn luyện thường rất hạn chế.
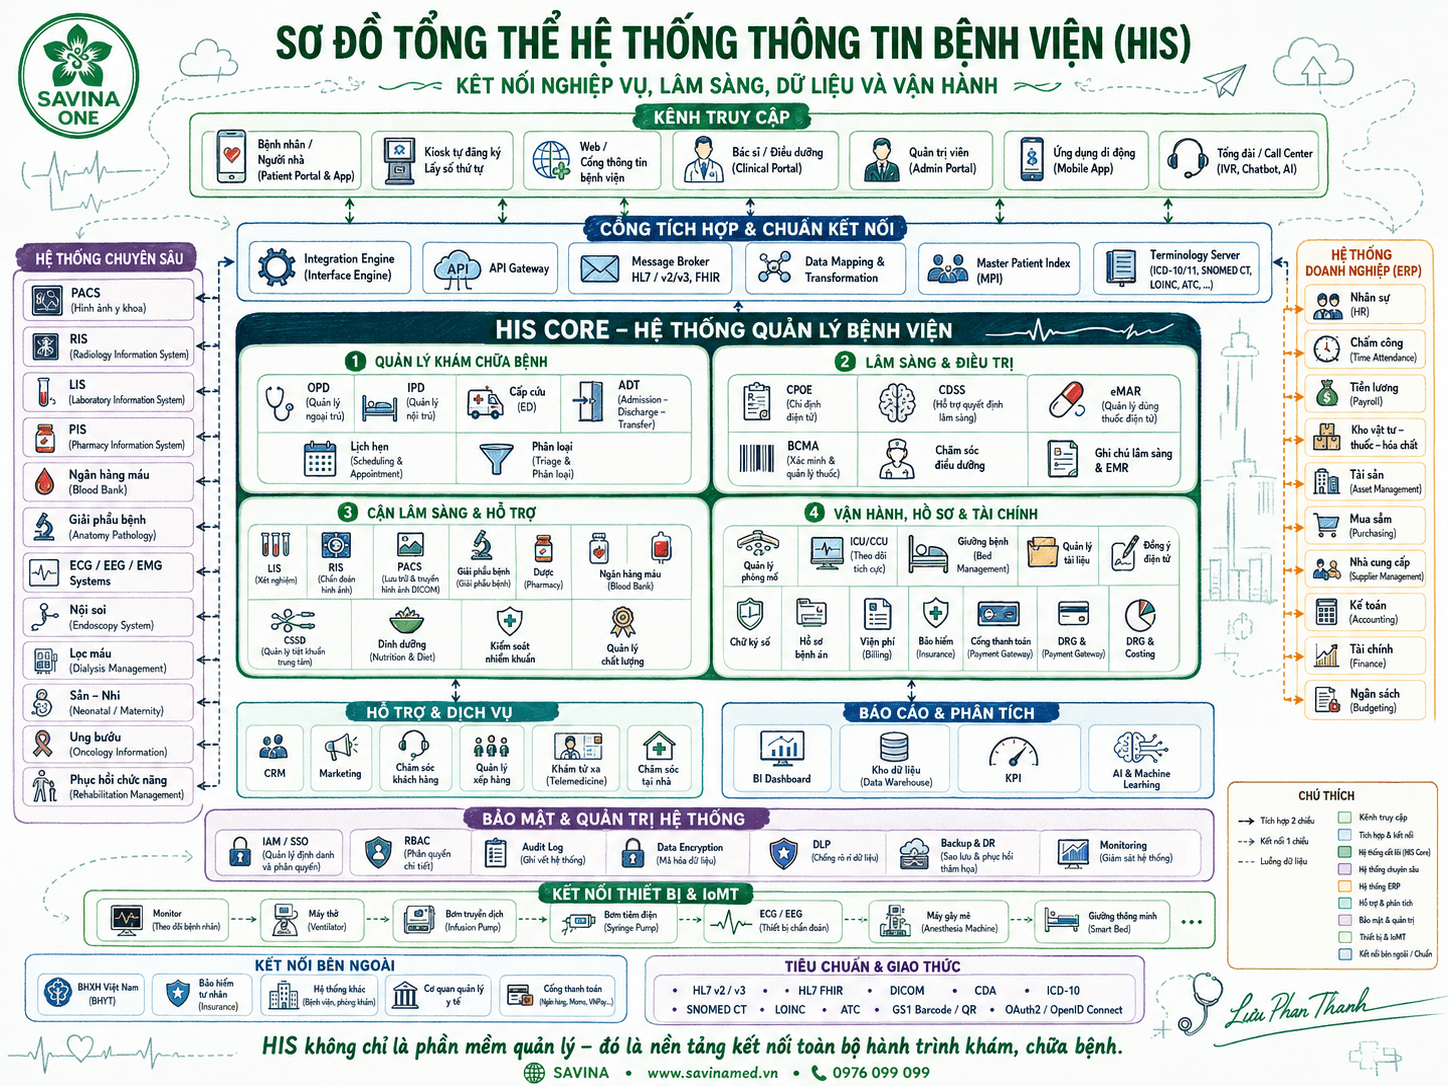
Tại các bệnh viện lớn, những tính năng này có thể tích hợp vào PACS, HIS hoặc hệ thống hỗ trợ quyết định lâm sàng (CDSS).
Sự thay đổi này giống như chuyển từ “học vẹt” sang “hiểu ngữ cảnh” – AI không còn bị giới hạn ở những gì nó đã được dạy, mà có thể suy luận dựa trên mô tả của con người.
Mặc dù Zero-Shot Vision có thể làm cho hệ thống “nhìn” trong y tế linh hoạt hơn rất nhiều, ứng dụng lâm sàng vẫn đòi hỏi sự thận trọng:
Kiểm chứng nghiêm ngặt trên dữ liệu thực tế của từng bệnh viện, từng dân số. Hiệu suất trên dữ liệu công khai (như CheXpert, Slake) không đảm bảo sẽ tốt trên dữ liệu nội bộ.
Giám sát phù hợp và cơ chế ghi log, cảnh báo khi AI không chắc chắn. Cần biết khi nào AI “đoán” thay vì “chắc chắn”.
Bắt buộc có bác sĩ xem xét, phê duyệt trước khi kết quả AI ảnh hưởng đến quyết định chẩn đoán – điều trị. AI là công cụ hỗ trợ, không phải người ra quyết định.
Phân phối dữ liệu khác biệt giữa các bệnh viện (máy CT khác nhau, protocol chụp khác nhau, dân số khác nhau) là nguyên nhân hàng đầu khiến mô hình giảm hiệu suất khi triển khai thực tế.
Chi phí tính toán với ảnh 3D (CT, MRI) và ảnh gigapixel (whole slide imaging) vẫn còn cao, đòi hỏi hạ tầng GPU và lưu trữ phù hợp.
Tương lai có thể không còn là “huấn luyện AI cho mọi thứ nó có thể gặp”. Mà ngày càng là: giúp AI hiểu được chúng ta muốn nó tìm cái gì – thông qua ngôn ngữ và mô tả của con người.
Một số hướng phát triển đáng chú ý:
Mô hình nền tảng đa modality: Một mô hình duy nhất cho CT, MRI, X-quang, siêu âm, mô bệnh học.
Tích hợp sâu vào workflow lâm sàng: AI không chỉ trả kết quả, mà còn trả lời câu hỏi, giải thích lý do, và đề xuất bước tiếp theo.
Học liên tục từ phản hồi bác sĩ: AI cải thiện dần qua từng lần bác sĩ sửa kết quả, mà không cần huấn luyện lại từ đầu.
Tiêu chuẩn hóa và quy định: FDA, CE và các cơ quan quản lý đang xây dựng khung đánh giá cho VLM trong y tế, đặc biệt về an toàn, minh bạch và trách nhiệm.
Zero-Shot Vision trong y tế mở ra một chương mới cho AI chẩn đoán hình ảnh: từ “học vẹt từng lớp” sang “hiểu mô tả để tìm kiếm”. Công nghệ này hứa hẹn giảm đáng kể thời gian và chi phí triển khai AI, đồng thời mở rộng phạm vi ứng dụng sang những bệnh hiếm, tổn thương khó mà trước đây không khả thi.
Tuy nhiên, để triển khai thành công trong lâm sàng, bệnh viện cần:
Kiểm chứng kỹ trên dữ liệu nội bộ,
Duy trì vai trò quyết định của bác sĩ,
Đầu tư hạ tầng tính toán và lưu trữ phù hợp,
Theo dõi sát hiệu suất và an toàn trong quá trình vận hành.
Nếu bạn đang tìm hiểu hoặc triển khai giải pháp AI cho khoa Chẩn đoán hình ảnh, PACS hoặc hệ thống hỗ trợ quyết định lâm sàng, hãy cân nhắc các nền tảng Vision-Language Models có khả năng zero-shot – đây có thể là chìa khóa để xây dựng hệ thống linh hoạt, bền vững và sẵn sàng cho tương lai.
Bạn quan tâm đến ứng dụng AI trong chẩn đoán hình ảnh?
Hãy để lại bình luận hoặc liên hệ để trao đổi thêm về cách tích hợp Zero-Shot Vision vào workflow bệnh viện của bạn.
September 14, 2026
September 12, 2026